Venice.ai - Unzensierte KI mit Privatsphäre und E2EE-Verschlüsselung
Die überwiegende Mehrheit von uns nutzt heute bereits KI. Und diejenigen, die sie noch nicht nutzen, werden es in Zukunft tun. Genau wie als das Internet kam und viele sagten, es sei für ihr Leben unwichtig, sich heute aber ein Leben ohne es nicht mehr vorstellen können. Diejenigen von euch, die bereits einen KI-Chatbot nutzen, bekommen ihn wahrscheinlich kostenlos und fragen sich vielleicht, warum gerade Venice.ai, wenn es eine kostenpflichtige Plattform ist. Die Antwort ist ein Wort: "Privatsphäre".
Die Venice.ai-Plattform speichert keine Chats auf ihren Servern. Sie werden nur lokal in deinem Browser gespeichert. Selbst bei einer gerichtlichen Anordnung können sie nicht herausgegeben werden, da sie einfach nicht auf Servern gespeichert sind und Mitarbeiter keinen Zugriff darauf haben. Venice.ai fungiert als Vermittler (Proxy) zwischen dir und dem KI-Modell. Es werden auch keine Logs und IP-Adressen gespeichert. Deine Daten werden nicht zum Training von Modellen verwendet. Im Gegensatz zu ChatGPT, der deine Daten speichert und zur Verbesserung seiner Modelle verwendet, lehnt Venice.ai diesen Ansatz ab.
Unzensierte KI
Es ist wichtig, zwei Dinge zu unterscheiden: Privatsphäre und Zensur.
Privatsphäre garantiert Venice.ai für alle Modelle - weder Venice noch dein ISP sehen, was du fragst. Das gilt auch für ChatGPT, Claude und Grok.
Zensur ist jedoch eine Eigenschaft des Modells selbst, nicht der Plattform. Wenn du ChatGPT über Venice etwas fragst, das OpenAI verbietet, wird das Modell die Antwort genau so verweigern, wie es auf chatgpt.com tun würde. Venice.ai kann die Systemanweisungen und Guardrails, die in das Modell eingebaut sind, nicht ändern.
Was Venice.ai bietet, sind Open-Source-Modelle ohne Guardrails - zum Beispiel DeepSeek, Llama, Mistral oder GLM. Diese Modelle sind nicht durch Unternehmensrichtlinien eingeschränkt und Venice.ai fügt ihnen keine eigenen Filter hinzu. Mit diesen Modellen erhältst du wirklich unzensierte Antworten. Wenn du KI ohne Zensur suchst, ist Venice.ai derzeit die beste Alternative auf dem Markt.
| Modell | Privatsphäre über Venice | Zensur |
|---|---|---|
| ChatGPT | Ja | Ja (OpenAI Guardrails) |
| Claude | Ja | Ja (Anthropic Guardrails) |
| Grok | Ja | Ja (xAI Guardrails) |
| DeepSeek | Ja | Nein (Open-Source, keine Guardrails) |
| GLM | Ja | Nein (Open-Source, keine Guardrails) |
| Llama | Ja | Nein (Open-Source, keine Guardrails) |
Wenn unzensierte KI für dich wichtig ist, nutze die auf Venice.ai verfügbaren Open-Source-Modelle. Wenn du Privatsphäre brauchst, aber Zensur nicht stört, kannst du auch ChatGPT oder Claude verwenden.
So greifst du auf das KI-Modell zu
- Du (Browser) → Sendest Prompt (verschlüsselt über HTTPS/TLS)
- Venice Proxy Server → Empfängt deine Anfrage, entfernt deine IP-Adresse, loggt nicht den Inhalt der Anfrage
- Backend KI-Server (wo GLM, DeepSeek etc. laufen) → Verarbeitet Prompt, generiert Antwort
- Venice Proxy Server → Gibt Antwort an dich zurück, speichert sie nirgendwo auf der Festplatte
- Du (Browser) → Antwort wird angezeigt und nur lokal in deinem Browser gespeichert
Wichtige Einschränkung
Der Venice-Proxy (für Private- und Anon-Modelle) hat keine Ende-zu-Ende-Verschlüsselung (E2EE) wie bei Signal oder ProtonMail. Der Venice-Proxy-Server kann technisch den Prompt-Inhalt während der Verarbeitung sehen, behauptet aber, ihn nicht zu loggen.
Nur E2EE TEE-Modelle (z.B. GLM) verwenden echte Ende-zu-Ende-Verschlüsselung, bei der der Venice-Proxy nur verschlüsselten Text sieht und der Inhalt erst innerhalb der TEE-Enklave entschlüsselt wird.
| Verschlüsselungstyp | Wer kann den Inhalt sehen? |
|---|---|
| E2EE (Signal) | Nur Sender und Empfänger |
| Venice (TLS-Proxy) | Venice-Proxy-Server kann technisch den Inhalt während der Verarbeitung sehen, behauptet aber, ihn nicht zu loggen |
Der Venice-Proxy muss den Prompt-Inhalt sehen, um ihn an das KI-Modell weitergeben zu können. Aber im Gegensatz zu ChatGPT speichert er ihn nicht.
Die Plattform trennt Identität vom Inhalt.
ChatGPT:
"Benutzer 192.168.1.1 (Max Mustermann) fragt nach: [sensibler Inhalt]" → Alles ist auf einem Server verbunden
Venice.ai:
Proxy weiß: "Jemand fragt nach [sensibler Inhalt]" (keine IP, kein Name)
Backend weiß: "Ich habe eine Anfrage für [sensiblen Inhalt] erhalten" (keine IP, kein Name)
→ Identität und Inhalt sind getrennt
Zur Klarstellung: Venice.ai hat 3 Arten von Modellen basierend auf dem Datenschutzniveau:
- E2EE TEE
- Private
- Anon
E2EE TEE-Modell
Das GLM-Modell (zum Zeitpunkt der Artikelerstellung GLM 5.2) läuft auf Venice.ai mit der höchsten Datenschutzstufe, die zwei fortschrittliche Technologien kombiniert: E2EE und TEE. Hier ist eine detaillierte Erklärung:
E2EE (End-to-End-Verschlüsselung)
E2EE bedeutet, dass deine Kommunikation auf deinem Gerät (im Browser) verschlüsselt wird und erst innerhalb der sicheren Umgebung entschlüsselt werden kann, in der das KI-Modell selbst läuft.
So funktioniert es:
- Du schreibst einen Prompt in deinem Browser.
- Der Browser generiert einen Verschlüsselungsschlüssel und verschlüsselt deinen Prompt.
- Der verschlüsselte Prompt reist über das Internet zu den Servern von Venice.
- Der Venice-Proxy-Server sieht nur unverständlichen verschlüsselten Text.
- Er kann nicht lesen, was du geschrieben hast.
- Der verschlüsselte Prompt wird an die isolierte Umgebung des Modells weitergegeben.
- Dort wird er entschlüsselt, verarbeitet und die Antwort wird verschlüsselt und zurückgesendet.
Vorteil: Kein Vermittler (weder Venice.ai, noch dein ISP, noch ein Hacker, der das Netzwerk abhört) kann deinen Prompt oder die Antwort des Modells lesen.
TEE (Trusted Execution Environment) - Vertrauenswürdige isolierte Umgebung
TEE ist ein hardware-isolierter Bereich im Prozessor des Servers (z.B. Intel SGX oder AMD SEV). Es funktioniert wie ein "Tresor im Inneren eines Computers". Code und Daten, die innerhalb des TEE laufen, sind vor allem anderen auf diesem Server geschützt - einschließlich des Server-Administrators und des Betriebssystems.
So funktioniert es im Kontext des GLM-Modells:
- Das KI-Modell GLM wird geladen und läuft innerhalb einer TEE-Enklave.
- Dein E2EE-verschlüsselter Prompt tritt in das TEE ein.
- Innerhalb des TEE wird der Prompt entschlüsselt und das Modell verarbeitet ihn.
- Niemand außerhalb des TEE (weder Venice.ai noch der Cloud-Server-Anbieter) kann die Daten innerhalb des TEE sehen. Selbst wenn jemand physischen Zugang zum Server erlangt und den RAM ausliest, würde er nur verschlüsselte Blobs sehen.
- Die Antwort wird innerhalb des TEE verschlüsselt und zurückgesendet.
Kombination von TEE + E2EE für GLM auf Venice.ai
Wenn du diese beiden Technologien kombinierst, erhältst du das, was man "Confidential AI" (Vertrauliche KI) nennt.
Warum ist das entscheidend?
Zero-Knowledge-Architektur: Venice.ai weiß buchstäblich nicht, worüber du mit dem GLM-Modell sprichst. Sie können dich nicht melden, dich nicht basierend auf Inhalten zensieren (weil sie die Inhalte nicht sehen) und deine Daten nicht verkaufen.
Schutz vor gerichtlichen Anordnungen: Selbst wenn Venice.ai eine gerichtliche Anordnung zur Herausgabe der Kommunikation eines bestimmten Benutzers erhielte, können sie nur verschlüsselten Text herausgeben, der ohne den Schlüssel in deinem Browser nicht entschlüsselt werden kann.
Schutz vor Datenlecks: Selbst wenn ein Hacker in die Server von Venice eindringt und alle Daten stiehlt, würde er nur verschlüsselte Blobs erhalten, die nutzlos sind.
Private-Modell
Es werden keine Prompt-Daten in irgendeiner Weise gespeichert - weder von Venice noch vom Modell-Anbieter.
Datenschutzniveau: Mittel/hoch. Es garantiert, dass nach der Generierung einer Antwort deine Anfrage sofort und dauerhaft aus dem Serverspeicher gelöscht wird. Niemand behält sie.
Anon (anonymisiertes) Modell
Der Modell-Anbieter kann den Text deines Prompts behalten, aber Venice entfernt alle Informationen über dich (IP-Adresse, Konto, Metadaten), bevor er gesendet wird.
Datenschutzniveau: Niedrigstes der drei. Deine Identität ist verborgen, aber der Inhalt deiner Anfrage kann vom Anbieter (z.B. dem Open-Source-Modell-Ersteller) geloggt und analysiert werden.
Preisgestaltung und Modelle
Venice.ai kostet weniger als ChatGPT Plus und es gibt auch eine kostenlose Version (die ist aber ziemlich eingeschränkt, was die Anzahl der täglichen Abfragen betrifft). Unten eine Preistabelle. Detailliertere Preisinformationen findest du auf der Website venice.ai/pricing.
| Stufe | Preis/Monat | Preis/Jahr | Was du bekommst |
|---|---|---|---|
| Free | $0 | $0 | 10 Text-Prompts/Tag, 15 Bilder/Tag, Basis-Modelle |
| Pro | $18 | $180 | Unbegrenzter Text, 1000 Bilder/Tag, 100 Credits/Monat |
| Pro Plus | $68 | $680 | Alles aus Pro + 7500 Credits/Monat, höhere Limits |
| Max | $200 | $2,000 | Alles aus Plus + 22500 Credits/Monat, höchste Limits |
Mit dem Basis-Plan hast du unbegrenzten Zugriff auf die Modelle GLM, DeepSeek und Google Gemma. Andere Modelle wie ChatGPT, Grok, Kimi K2 und Claude sind gegen Credits verfügbar, die du dazukaufen kannst. Du kannst sowohl für Credits als auch für monatliche oder jährliche Abonnements online per Karte oder mit Kryptowährungen bezahlen.
Credits
Credits sind die universelle Währung von Venice.ai für Premium-Funktionen. Sie werden für Video-Generierung, Musik, Zugang zu Premium-Modellen (wie ChatGPT, Claude oder Grok) und für API-Zugang verwendet. Jeder kostenpflichtige Plan enthält ein monatliches Credit-Kontingent. Da die Umrechnung einfach ist - 100 Credits = $1 - weißt du immer genau, wie viel du tatsächlich ausgibst.
Monatliches Credit-Kontingent:
- Pro: 100 Credits monatlich (Wert $1)
- Pro Plus: 7.500 Credits monatlich (Wert $75)
- Max: 22.500 Credits monatlich (Wert $225)
Credit-Banking (Übertrag in den nächsten Monat)
Pro Plus und Max Pläne bieten Credit-Banking. Das bedeutet, dass nicht genutzte Credits am Ende des Monats nicht verschwinden, sondern in die nächste Periode übertragen werden. Bei Pro Plus halten Credits bis zu 2 Monate, bei Max bis zu 3 Monate.
Credit-Bonus beim Kauf
Nutzer mit höheren Plänen haben einen Vorteil beim Kauf zusätzlicher Credits. Pro Plus-Nutzer erhalten 10 % Bonus und Max-Nutzer 12,5 % Bonus. Wenn also ein Max-Nutzer Credits im Wert von $100 kauft, erhält er Credits im Wert von $112,50.
Willkommens-Credits für neue Nutzer
Alle neuen Nutzer erhalten einmalig 500 Willkommens-Credits (Wert $5) bei der Registrierung. Dies ermöglicht es auch Nutzern der kostenlosen Version, Premium-Funktionen wie Video-Generierung oder fortschrittliche Modelle auszuprobieren, bevor sie sich für ein kostenpflichtiges Abonnement entscheiden.
Venice.ai-Tokenomik
Venice.ai hat eine eigene Tokenomik, die auf der Base-Blockchain aufgebaut ist:
VVV-Token - Utility-Token von Venice.ai, der als Zugangsschlüssel für KI-Agenten und Entwickler dient, um die Venice-API ohne Bezahlung für jede Anfrage zu nutzen. Initiales Angebot waren 100 Millionen Token, Inflation beträgt 6 Millionen pro Jahr.
DIEM-Token - Staking-Token, der passives Einkommen ermöglicht. Jeder gestakte DIEM gibt $1 täglich an API- oder In-App-Credit. DIEM ist ein frei handelbarer Token auf der Base-Blockchain. Neue DIEM können durch Locken von gestaktem VVV (sVVV) zur aktuellen Mint-Rate geprägt werden, aber DIEM kann auch auf dezentralen Börsen gekauft werden.
Airdrop - Venice.ai hat den größten Airdrop in der Geschichte der Base-Blockchain durchgeführt. Weitere Airdrops sind nicht geplant; Season 2 VVV-Airdrop wird nicht stattfinden.
Das Token-Dashboard ist verfügbar unter venice.ai/token.
API für Entwickler
Venice.ai bietet eine OpenAI-kompatible API. Das bedeutet, dass Entwickler die ChatGPT-API durch die Venice-API ersetzen können, ohne den Code ändern zu müssen. Für datenschutzbewusste Entwickler ist es eine ideale Lösung - sie erhalten die Leistung von OpenAI-Modellen, ohne dass ihre Daten auf Servern großer Technologieunternehmen landen.
Die API unterstützt dieselben Endpunkte wie OpenAI, sodass die Migration eine Frage der Änderung der Base-URL und des API-Schlüssels ist. API-Zugang ist auch in der Free-Stufe verfügbar.
Was Venice.ai alles kann
Venice.ai ist nicht nur ein KI-Chatbot. Die Plattform bietet eine breite Palette von Funktionen, die sie zu einem umfassenden KI-Werkzeug machen:
- Text-Chat - unbegrenzte Konversationen mit GLM, DeepSeek, Google Gemma und anderen Modellen
- Bildgenerierung - 15 Bilder pro Tag kostenlos, 1000 pro Tag in der Pro-Version
- Video-Generierung - über Venice Video Studio
- Musikgenerierung - Erstellung von Audio-Inhalten mit KI
- Text-to-Speech - Umwandlung von Text in gesprochene Sprache
- Vision - KI kann hochgeladene Bilder und Fotos analysieren
- Dokument-Uploads - PDF- und Textdatei-Unterstützung für Analyse
- Web-Suche - KI kann das Internet durchsuchen und aktuelle Informationen liefern
- Bild-Upscaling - Vergrößerung und Verbesserung der Bildqualität
- Hintergrundentfernung - Bildbearbeitung (verfügbar für Pro-Nutzer)
- NSFW-Inhalte - Venice.ai unterstützt explizit die Generierung unzensierter Inhalte einschließlich NSFW-Bilder (im Gegensatz zu ChatGPT oder Claude, die dies streng verbieten)
- Charaktererstellung - erstelle und teile benutzerdefinierte KI-Charaktere mit einzigartigen Persönlichkeiten
- Wasserzeichen-Entfernung - Entfernen von Wasserzeichen aus generierten Bildern
- Generative Bildbearbeitung - fortschrittliche Bearbeitungswerkzeuge für die Modifikation von KI-Bildern
- Erweitertes Kontextfenster - für lange Konversationen und tiefe analytische Arbeit (Pro-Stufe)
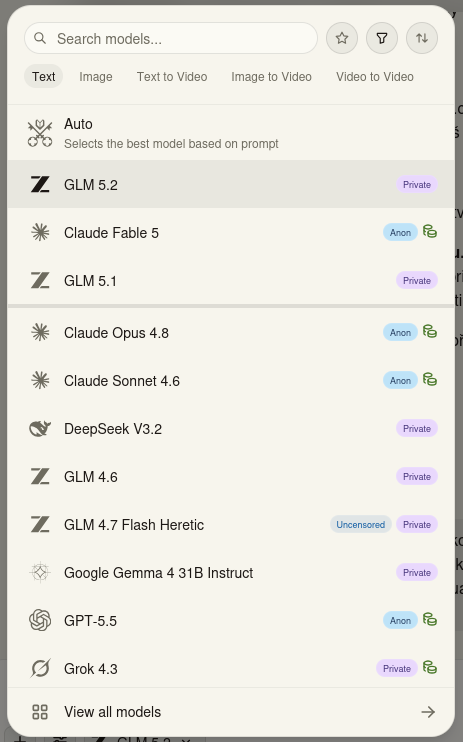
Abb.1: Menü mit Modi und Chatbots
Aus Abbildung 1 ist ersichtlich, dass die Plattform neben dem Textmodus auch Modi für die Arbeit mit Bildern und Video bietet.
Agentic Chat
Die Venice.ai-Plattform bietet neben dem regulären Chat auch Agentic Chat. Was ist der Unterschied zwischen Agentic Chat und normalem Chat?
Agentic Chat (oft als KI-Agent bezeichnet) ist ein Chat, bei dem künstliche Intelligenz nicht nur passiv antwortet, sondern aktiv Aufgaben löst, mit Autonomie und der Fähigkeit, Werkzeuge zu verwenden. Agentic Chat gilt als der nächste große Schritt in der KI-Entwicklung. Es geht nicht mehr nur darum, dass KI Dinge "weiß", sondern dass sie mit der digitalen Welt interagieren kann. Beispiele sind KI-Assistenten in Büroanwendungen (wie Microsoft Copilot), die dein Postfach durchsuchen, Daten in Excel analysieren und sie direkt in PowerPoint konvertieren können.
System-Prompt
Ein System-Prompt (manchmal "System Message" oder "Custom Instructions" genannt) ist die Grundeinstellung oder "Persönlichkeit" der KI, die du definierst, bevor du überhaupt mit der KI kommunizierst.
Es ist keine Frage, die die KI beantworten soll. Es sind die permanenten Spielregeln, die die KI bei jeder weiteren Nachricht, die du schreibst, einhalten muss.
Wie es bei der KI funktioniert
Wenn du das Feld für den System-Prompt in den Einstellungen ausfüllst, werden diese Anweisungen nicht nur als Notiz gespeichert. Die KI nimmt sie und fügt sie ganz am Anfang jeder neuen Konversation ein, die du beginnst. Das Bild unten zeigt das geöffnete System-Prompt-Menü.
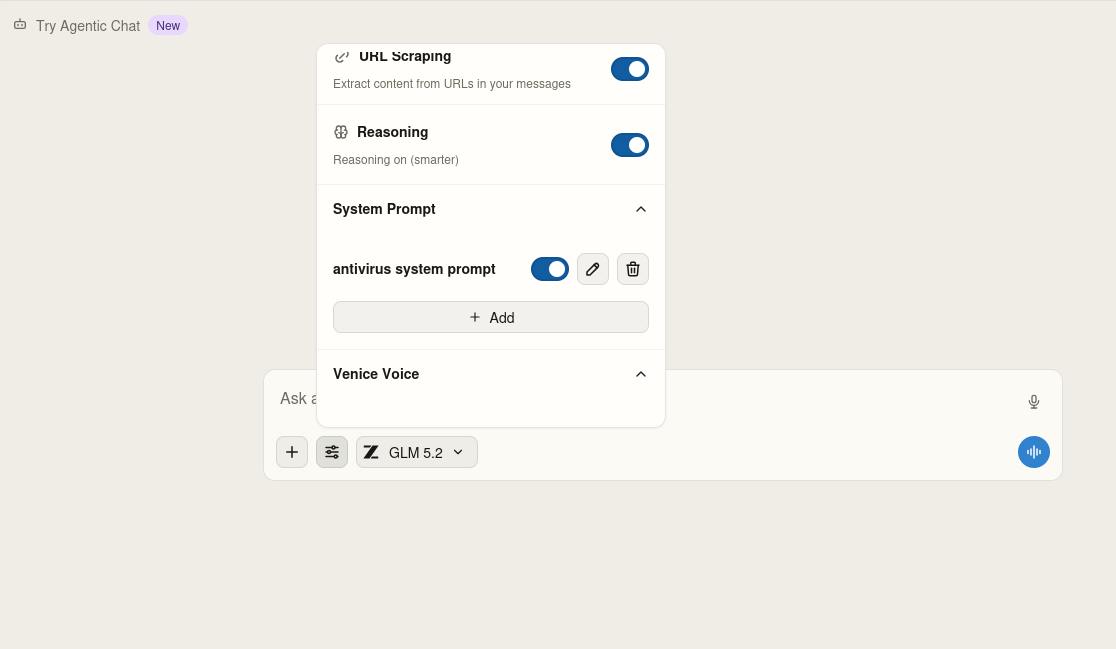
Abb.2: System-Prompt
Beispiel für einen System-Prompt:
"Antworte detailliert und präzise. Konzentriere dich auf Fakten und Korrektheit der Antworten. Überprüfe unsichere Informationen, wenn möglich. Wenn du auf bestimmte Informationen nicht zugreifen kannst, erfinde nichts und sage, dass du nicht darauf zugreifen kannst. Wenn die Frage unklar ist, frage nach Klärung, anstatt langwierig zu spekulieren."
Du stellst dies einmal in den Einstellungen ein und die KI wird es automatisch auf alles anwenden, was du jemals schreibst. Es spart Zeit und stellt sicher, dass die KI konsistent genau so reagiert, wie du es möchtest.
Lass mich noch eine wichtige Sache hinzufügen. Am Anfang des Artikels habe ich erwähnt, dass dein Chat-Verlauf lokal in deinem Webbrowser gespeichert wird. Das bedeutet, dass wenn du dich auf einem anderen Gerät in dein Konto einloggst, du dort deinen Chat-Verlauf nicht sehen wirst.
Verschlüsselte Chat-Sicherung
Für die Pro-Stufe und höher gibt es eine Funktion zur verschlüsselten Chat-Sicherung und -Wiederherstellung. Dies löst das Problem, das ich oben erwähnt habe - dass der Chat-Verlauf nur lokal auf einem bestimmten Gerät gespeichert wird. Mit der Pro-Stufe kannst du Chats verschlüsselt sichern und auf einem anderen Gerät wiederherstellen, ohne dass Venice.ai Zugriff darauf hat.
Unten ein Screenshot der Venice.ai-Weboberfläche.
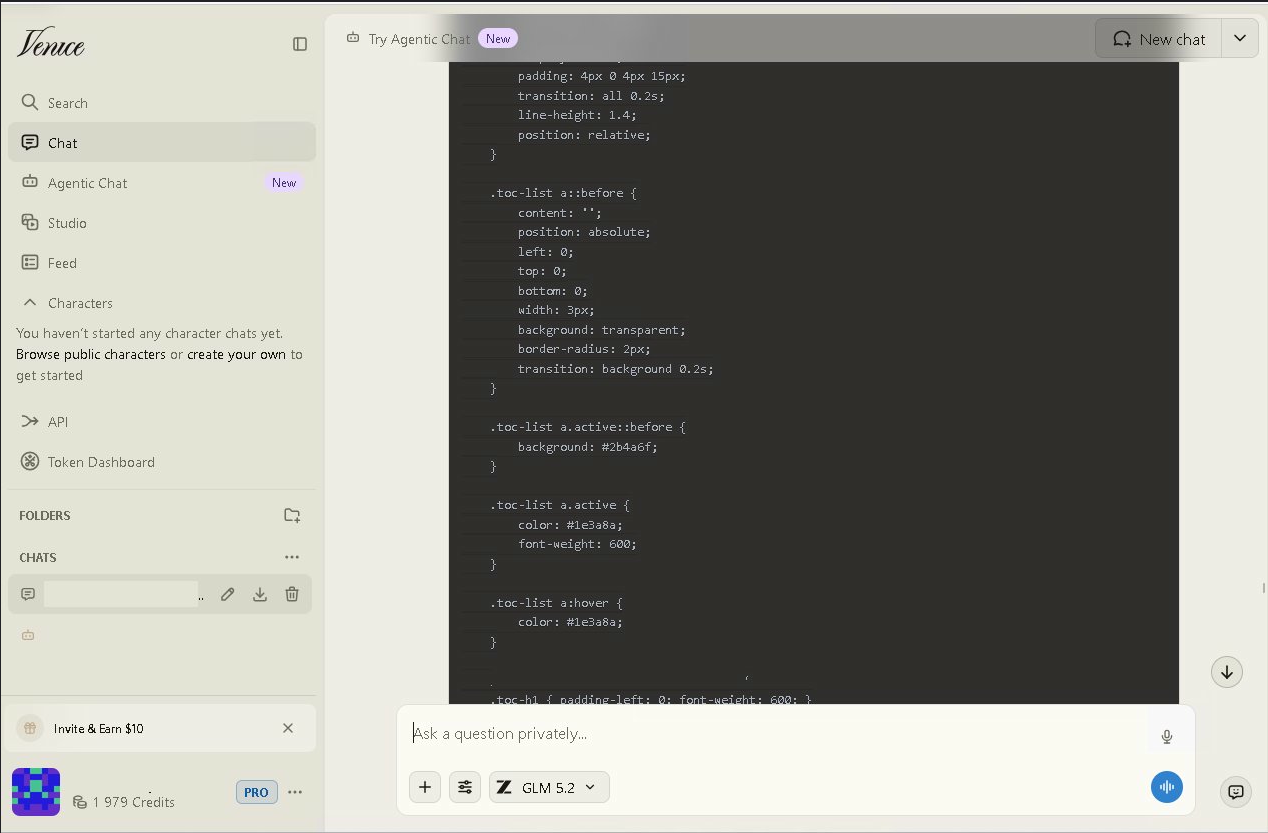
Abb.3: Venice.ai Weboberfläche
In Abb.3 kannst du sehen, wie die Weboberfläche von Venice.ai aussieht. Du kannst es kostenlos auf venice.ai ausprobieren - du hast die Möglichkeit, dem Chatbot 10 Fragen pro Tag zu stellen.
Die Plattform entwickelt sich sehr schnell, sodass die KI nicht nur über die Weboberfläche verfügbar ist, sondern auch eigenständige Apps anbietet. Ich habe die Android-App getestet und muss sagen, dass die Reaktion auf Fragen/Prompts viel flüssiger war als am PC in der Weboberfläche.
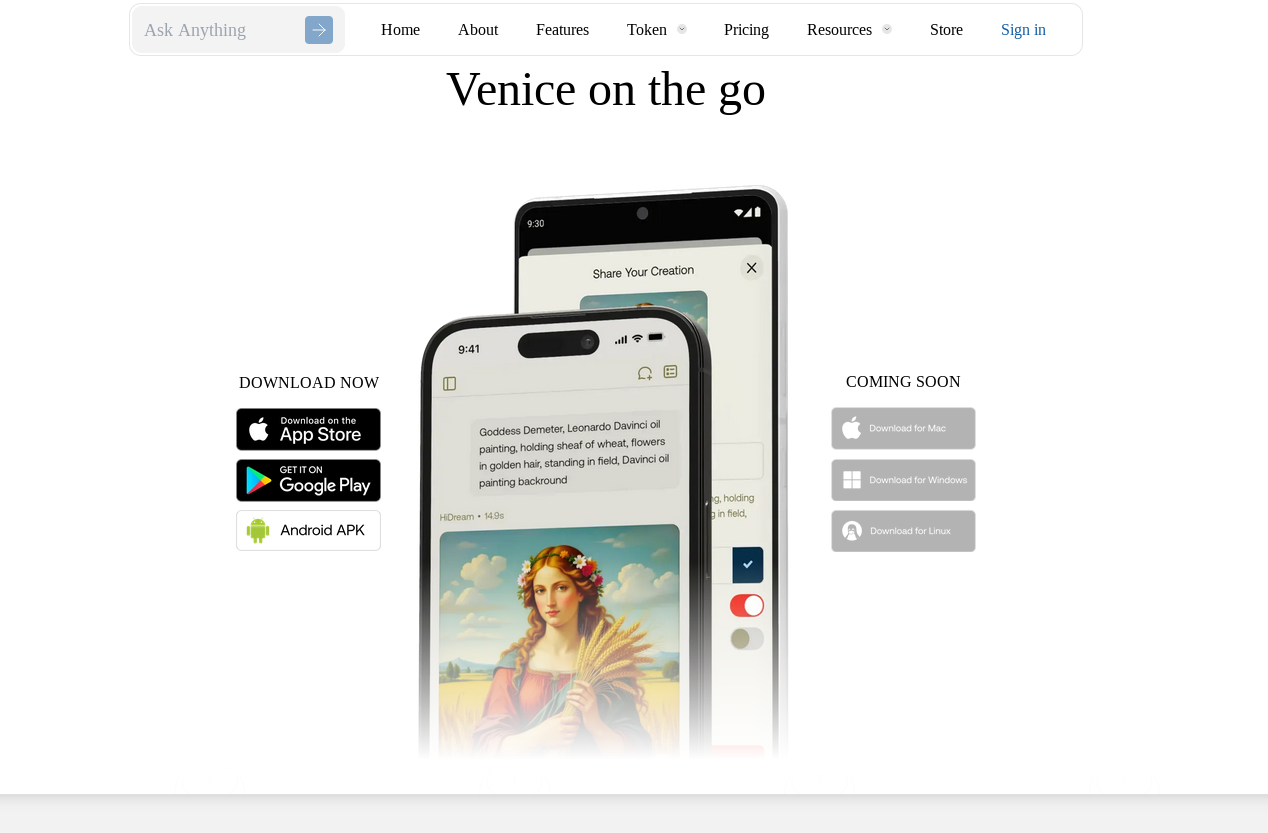
Abb.4: Plattformen, auf denen du die App herunterladen kannst
Abb.4 zeigt, auf welchen Plattformen Venice.ai verfügbar ist und in naher Zukunft verfügbar sein wird.
Vergleich mit der Konkurrenz
| Plattform | Privatsphäre | Zensur | Preis/Monat | Tokenomik |
|---|---|---|---|---|
| ChatGPT | Keine | Ja | $20 | Nein |
| Claude | Keine | Ja | $20 | Nein |
| Venice.ai | E2EE+TEE | Teilweise (hängt vom Modell ab) | $18 | Ja (VVV, DIEM) |
| Lokales Ollama | Maximal | Nein | Kostenlos | Nein |
Wie du siehst, ist Venice.ai die einzige Plattform, die E2EE+TEE-Datenschutz, unzensierte Modelle und eine eigene Tokenomik kombiniert. Lokales Ollama bietet maximale Privatsphäre, erfordert aber eigene Hardware und technisches Wissen.
Wenn dich interessiert, wie du Krypto ausgeben kannst, ohne dass die Bank davon erfährt, wie du deine Identität von deinem Geld trennst, lies meine Rezension der ether.fi Cash Card. Und wenn du wissen möchtest, wie du eine sichere Cloud einrichtest, schau dir meinen Artikel über verschlüsselten Speicher an. Abschließend erwähne ich noch den Artikel Verschlüsselte E-Mail - ProtonMail, in dem ich E-Mail mit Schwerpunkt auf Privatsphäre und Sicherheit behandle.